产品亮点
支持PDF、DOC、PPT、XLS的布局分析与OCR
分块处理,输出结构化文本、表格、图像和手写内容
提供API接口,方便集成到自己的应用
提供1500页免费使用额度
附API文档和GitHub资源,便于学习和使用
你能用它做什么
- 企业把PDF工单转成结构化数据,便于分析和检索
- 研究者把学术论文转成机器可读格式做文本分析
- 教育机构把教材讲义转成数字化内容用于在线教学
怎么用
- 1 访问Chunkr官网并注册账户
- 2 登录后创建新的数据摄取任务
- 3 上传文档,支持PDF、DOC、PPT和XLS格式
- 4 系统自动进行布局分析、OCR和分块处理
- 5 下载或通过API获取处理后的结构化数据
- 6 参考API文档和GitHub资源深入了解功能
- 7 按规模需要选择合适的定价方案
适合谁使用
要为RAG或LLM应用准备数据的开发者需要批量处理文档的企业和团队把论文和资料数字化的研究者和教育机构要把客服记录等PDF工单转为可检索数据的运营方
优点
- 一个接口覆盖布局分析、OCR和分块,流程省事
- 输出结构化数据,直接适合RAG和LLM场景
- 提供1500页免费额度,试错成本低
- 有API文档和GitHub资源,集成参考充分
局限
- 免费额度用完后需要选择付费方案,规则可能调整
- 作为开源服务,实际可用性和维护节奏取决于上游项目
- 扫描质量和手写内容的识别效果受原文件质量影响
- 接入需要一定开发能力,非技术用户上手有门槛
Chunkr 是什么
Chunkr 是一个开源的数据摄取API服务,专注文档布局分析、OCR和分块处理,把PDF、DOC、PPT和XLS等文件转换成适合RAG和LLM使用的数据格式。它能对文本、表格、图像和手写内容做结构化处理,由Lumina AI Inc.维护。官方提供1500页免费额度,并给出API文档和GitHub资源供开发者参考。
你能用它做什么
- 上传PDF、DOC、PPT、XLS文档,自动完成布局分析和OCR。
- 把文档内容分块成结构化的文本、表格、图像和手写部分。
- 通过API接口把处理结果接入自己的应用或数据流程。
- 把转换后的结构化数据用于分析、模型训练或业务流程。
适合谁使用
- 需要为RAG或LLM应用准备数据的开发者。
- 要把大量历史文档数字化的企业和团队。
- 处理学术论文和教材资料的研究者与教育机构。
- 需要把客服记录等PDF工单转为可检索数据的运营方。
需要留意什么
1500页免费额度用完后需要选择定价方案,具体规则以官网说明为准。作为开源服务,它的可用性和维护节奏取决于上游项目,接入前建议关注GitHub上的更新情况。扫描件清晰度、手写内容和复杂表格会影响识别效果,重要数据需要人工抽检。接入方式以API为主,对没有开发能力的用户来说上手门槛较高。
常见问题
Chunkr 支持哪些文件?
支持PDF、DOC、PPT和XLS格式的文档。
免费额度有多少?
官方提供1500页的免费使用额度。
怎么拿到处理结果?
可以下载,也可以通过API接口获取结构化数据。
需要会编程吗?
主要通过API集成,适合有开发能力的用户,可参考API文档和GitHub资源。
为什么说它免费
官网写明的免费方式: 免费试用免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
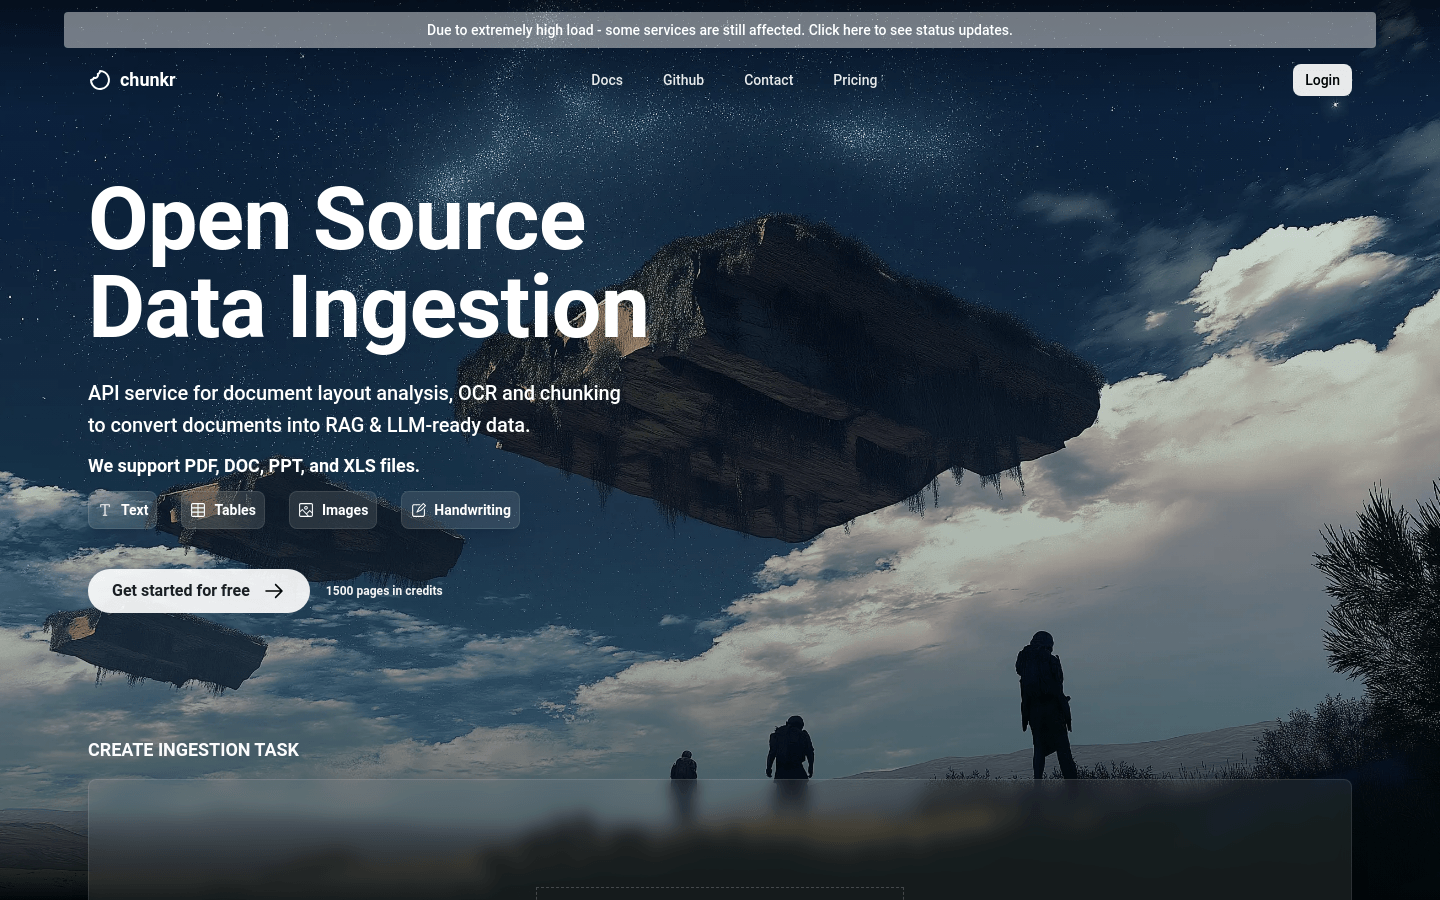
截图归档自收录页面,仅供预览参考。