llama-ocr
基于Llama 3.2 Vision的OCR库免费npm库,图片直接转markdown
开发与工具AI模型 together aivLLMs开源AI 模型OCRLlama
前往官网 →
产品亮点
开源npm库,安装即用
基于Llama 3.2 Vision识别图像
本地与远程图片都支持
输出markdown格式文本
你能用它做什么
- 开发者在项目中集成图像文本自动识别。
- 企业自动化处理纸质文档电子化。
- 个人从图片中快速提取关键信息。
怎么用
- 1 执行npm i llama-ocr安装依赖。
- 2 在代码中导入llama-ocr模块。
- 3 配置所需的API密钥。
- 4 调用OCR功能处理本地或远程图片。
- 5 解析返回的markdown结果,按需切换模型。
适合谁使用
需要OCR能力的开发者做文档自动化的团队能写代码的技术用户
优点
- 开源免费,流程自己掌控
- 输出markdown,便于后续处理
- 支持本地和远程图片输入
局限
- 需要配置API密钥并写代码集成,有学习成本。
- PDF OCR尚在计划中,目前只处理图像。
- 免费与付费模型的调用规则可能变化,包页面访问也可能不稳定。
llama-ocr 是什么
llama-ocr 是一个开源的 npm 库,免费使用,基于 Llama 3.2 Vision 做图像文字识别。它把图片内容解析成 markdown 格式文本,方便直接进入后续处理流程。项目受 Zerox 启发,提供免费和付费两种模型接口,需要使用者自行配置 API 密钥。
你能用它做什么
- 识别本地图片中的文字,输出 markdown 文本。
- 传入远程图片地址,直接完成 OCR 处理。
- 在不同模型之间切换,按效果和成本取舍。
- 集成进脚本或服务,做文档电子化和信息提取。
适合谁使用
- 需要在项目里加 OCR 能力的开发者。
- 要把纸质文档批量转成文本的企业和团队。
- 习惯写代码、想自己控制流程的技术用户。
需要留意什么
它不是一个打开网页就能用的成品工具,需要配置 API 密钥并写代码集成,对不写代码的人来说门槛偏高。单页和多页 PDF 的 OCR 还在计划中,目前只能处理图像,扫描件要先自己拆图。免费与付费模型的调用规则可能变化,包页面访问也可能不稳定,接入前建议先读一遍当时的项目文档。
常见问题
llama-ocr收费吗?
库本身开源免费,但调用模型时提供免费和付费两种选项,具体规则以项目文档说明为准。
支持PDF吗?
单页和多页PDF的OCR还在计划中,当前版本处理的是本地图像和远程图像地址。
输出是什么格式?
默认把图像解析为markdown格式文本,方便直接进入后续处理流程,未来可能支持JSON输出。
为什么说它免费
官网写明的免费方式: 免费使用免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
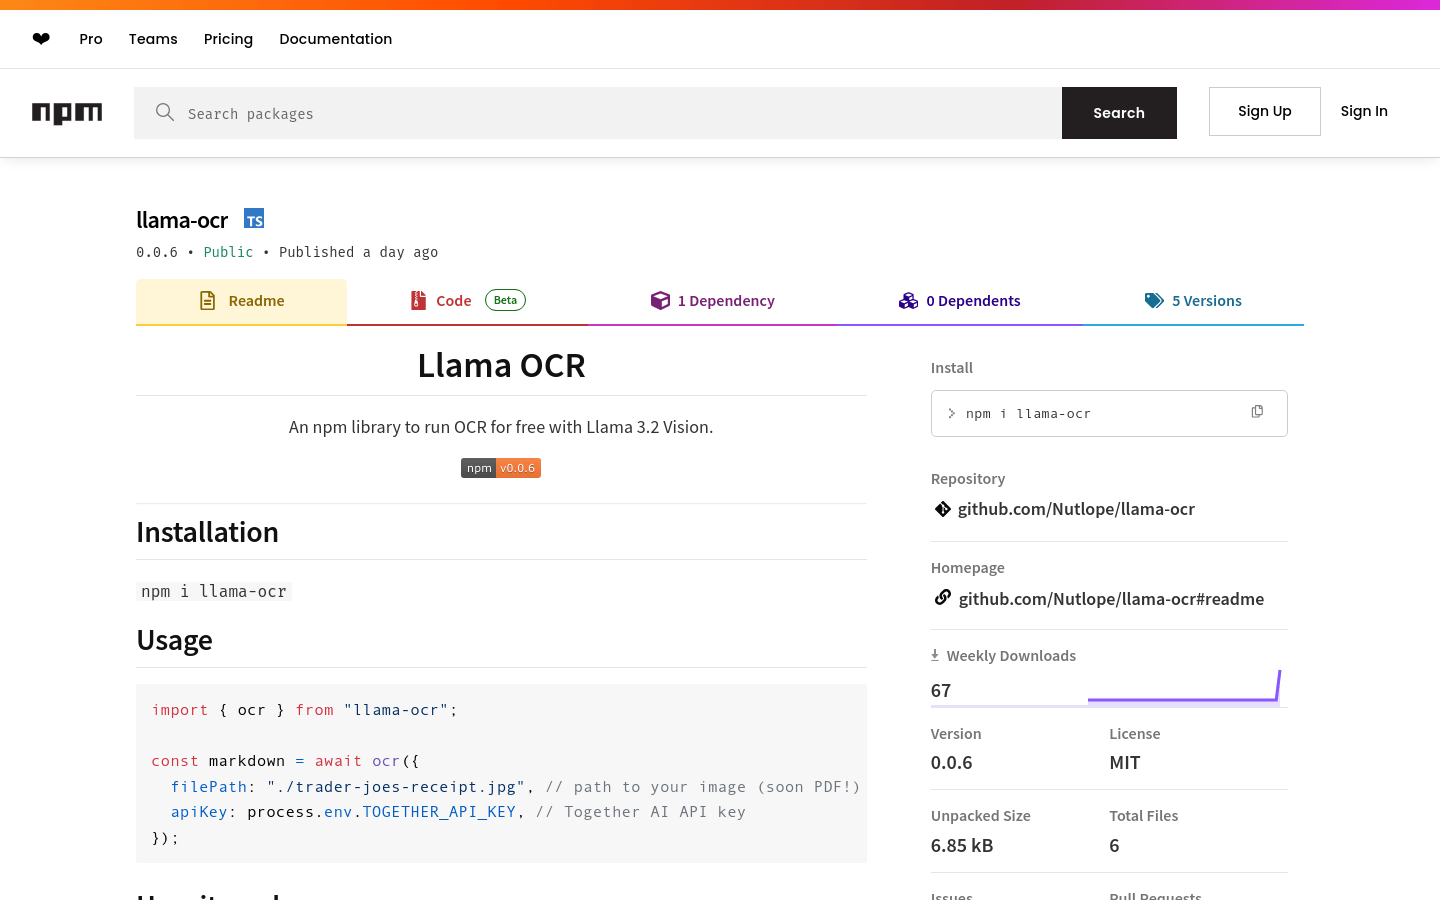
截图归档自收录页面,仅供预览参考。