产品亮点
支持 JavaScript 渲染抓取
输出 Markdown、文本或 HTML
可同时抓取多个网站
注册送 25 美元免费额度
你能用它做什么
- 抓取网页内容并整理成 Markdown,供 AI 处理使用。
- 批量采集多个站点数据,存入自带存储后分析。
- 通过 Webhook 获取任务状态,接入自有自动化流程。
怎么用
- 1 访问官网注册账号,过程无需信用卡。
- 2 获取 API 密钥,并阅读官方接口文档。
- 3 提交目标网址,并设置输出格式。
- 4 用 CSS 选择器过滤不需要的内容。
- 5 通过 Webhook 或存储读取抓取结果。
适合谁使用
需要采集数据的开发者为AI应用准备语料的团队要跟踪网页变化的研究人员
优点
- 抓取速度快,输出格式干净
- 能处理 JS 渲染的动态页面
- 新用户有 25 美元免费额度
局限
- 免费额度用完需付费,规则可能变动
- 部分站点有反爬限制,需自行遵守规则
- 接口调用需要一定开发基础
UseScraper Crawler 是什么
UseScraper 是一个网络爬虫与数据抓取 API,目标是快速拿到网页内容。它支持浏览器渲染,能处理依赖 JavaScript 的复杂网站,输出格式包括 HTML、纯文本和 Markdown。注册无需信用卡,新用户可获得 25 美元免费使用额度,适合先跑通流程再按量付费。
你能用它做什么
- 抓取单个或多个网站的内容并转成 Markdown
- 排除指定 URL,或用 CSS 选择器去掉重复内容
- 用 Webhook 接收抓取任务的状态更新
- 把结果存入自带存储,到期自动清理
适合谁使用
- 需要采集网页数据的开发者
- 为 AI 应用准备语料和素材的团队
- 要跟踪网页变化的研究与运营人员
需要留意什么
免费额度用完就需要付费,额度规则和价格可能随官方调整,使用前建议查看当前定价页面。部分网站有反爬机制和访问限制,抓取前要确认用途符合对方规定,避免违规。调用 API 需要一定开发基础,完全没有编程经验的用户会有学习成本。
常见问题
注册需要付费吗?
不需要信用卡即可注册,新用户可获得 25 美元免费使用额度,后续用量按定价方案计费。
能抓取需要登录的网站吗?
工具支持浏览器渲染,可爬取依赖 JavaScript 的复杂网站,具体能否访问需看目标站点的限制和你的使用方式。
抓取结果能保存多久?
产品提供数据存储与自动过期机制,过期后数据不再保留,重要内容建议及时导出备份。
为什么说它免费
官网写明的免费方式: 免费使用免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
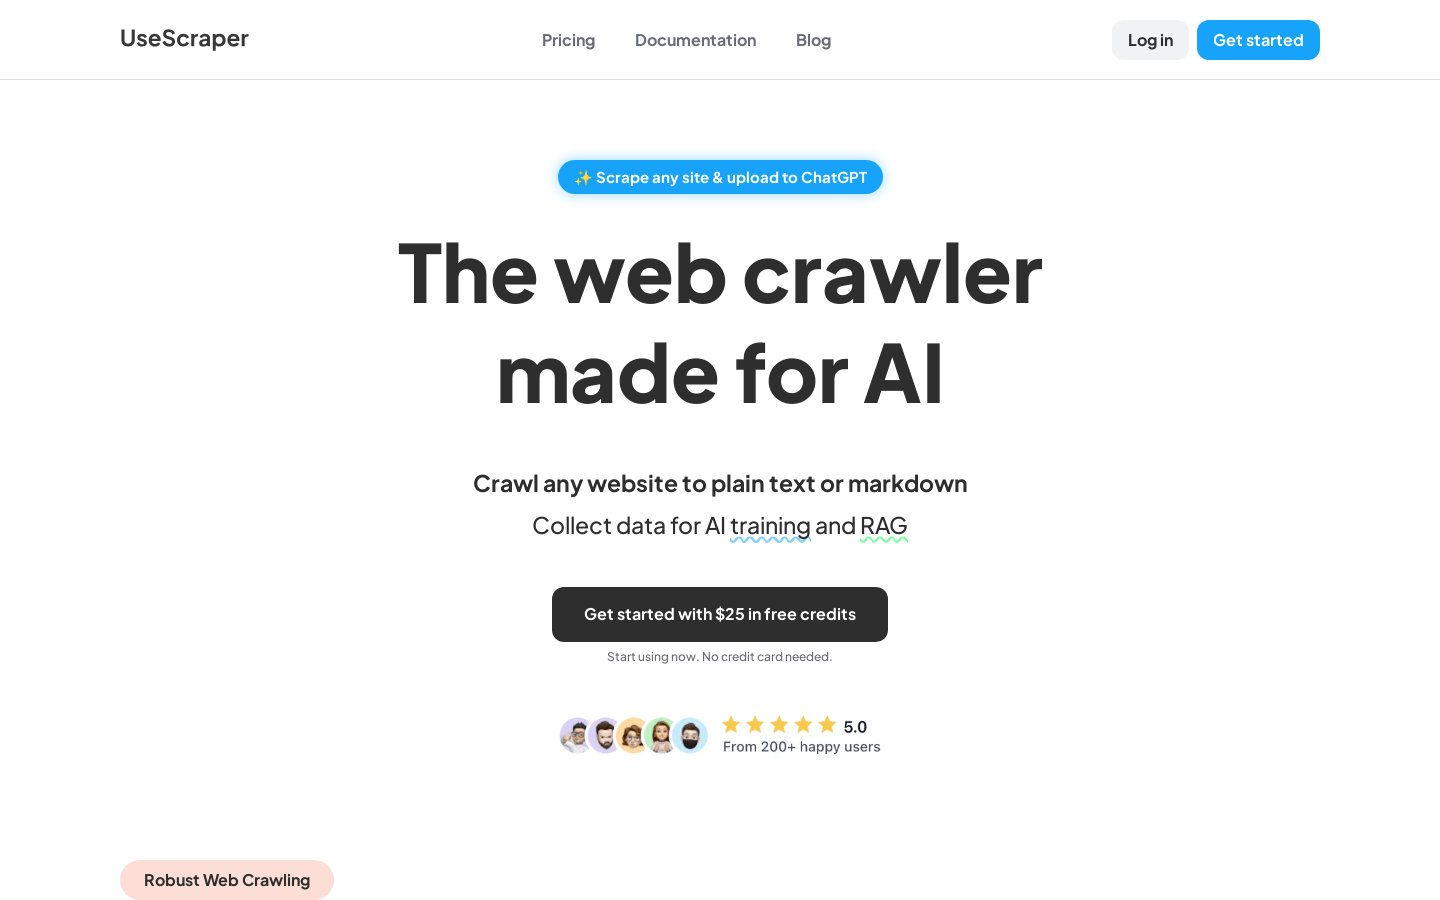
截图归档自收录页面,仅供预览参考。