产品亮点
实时生成与语音匹配的口型动画
自动模拟面部表情,反应更自然
基于深度学习算法
提供自然流畅的交互体验
来自微软研究院的技术项目
你能用它做什么
- 在线教育平台用虚拟教师做课程讲解
- 视频会议中让远程参与者形象更逼真
- 游戏开发者为角色加入自然表情
怎么用
- 1 访问微软研究院的 VASA-1 项目页面
- 2 查看公开的演示与说明,了解模型能力
- 3 按页面指引申请体验或查看开放进度
- 4 在支持的环境里输入音频测试生成效果
- 5 结合自己的场景评估是否适用
适合谁使用
关注数字人技术的研发人员需要虚拟教师形象的教育产品团队想让游戏或虚拟角色表情更自然的开发者
优点
- 口型和表情能跟着语音实时生成
- 交互体验比预渲染动画更自然
- 有微软研究院的技术背景支撑
局限
- 定价与开放方式尚未明确,不能当作成熟产品直接采购
- 作为研究项目,集成和使用有一定技术门槛
- 生成的人像涉及肖像与真人相似度问题,用于对外内容时需确认授权与合规
- 具体免费试用范围可能随项目进展调整
VASA-1 是什么
VASA-1 是微软研究院的一个模型,做的事是用语音实时驱动人脸动画。你给它一段音频,它通过深度学习算法生成对应的口型和面部表情,让虚拟角色的反应更接近真人,交互过程也更自然。项目页面对外展示了技术能力,但定价策略尚未公布,官方提到预计提供免费试用版本,实际能否使用要看开放进度。
你能用它做什么
- 输入语音,实时生成与音频匹配的口型动画
- 让虚拟形象自动带上相应的面部表情
- 在教育、会议、游戏等场景里做更自然的角色互动
- 作为数字人技术的参考方案进行评估
适合谁使用
- 关注数字人与语音驱动动画的研发人员
- 需要虚拟教师形象的在线教育团队
- 希望给游戏角色加自然表情的开发者
需要留意什么
VASA-1 目前更接近研究项目,不是拿来就能用的成熟产品,集成需要一定的技术能力,定价和开放方式也还没明确。它生成的人脸与真人的相似度较高,用在对外内容、商业素材或涉及具体人物形象时,要确认肖像授权和平台规范,避免踩线。免费试用的具体范围也可能随项目进展变化,以官方页面说明为准。
常见问题
VASA-1 是已经上线的产品吗?
它是微软研究院的项目页面,更接近研究阶段,定价和开放方式尚未公布。
它能做什么?
输入语音后实时生成匹配的口型和面部表情动画。
普通人可以直接用吗?
需要看项目页面的开放进度,目前更偏向研究与体验申请。
为什么说它免费
官网写明的免费方式: 免费试用免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
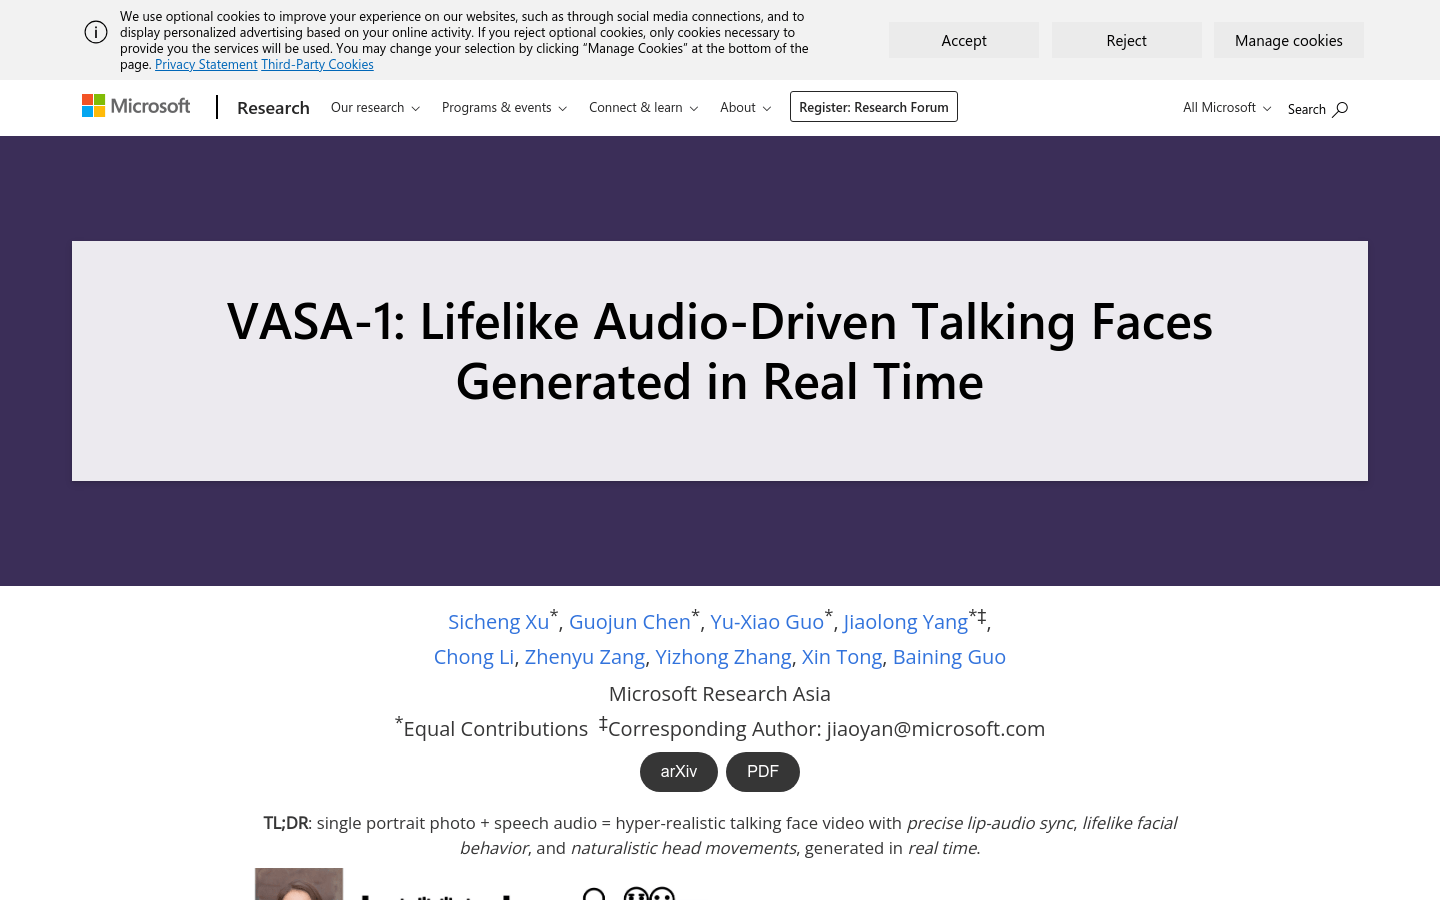
截图归档自收录页面,仅供预览参考。