产品亮点
完全开源,代码可自由修改
支持多种语言和输入形式
语音合成效率高,响应快
支持Docker等多种灵活部署
你能用它做什么
- 开发者基于它构建多语言文本转语音应用功能。
- 研究人员用它开展语音合成与模型效果实验。
- 学生团队基于模型开发个性化语音交互应用。
怎么用
- 1 获取Whisper Speech开源代码和文档。
- 2 根据项目选择Python、Node.js或HTTP调用方式。
- 3 准备需要合成的文本内容,并设置目标语言。
- 4 运行模型生成语音,试听效果并按需调整。
适合谁使用
需要TTS能力的开发者做语音实验的研究人员想练手的学生团队
优点
- 开源免费,可二次定制
- 输入形式多,集成灵活
- 多语言支持,适用面广
局限
- 需要技术基础,部署有学习成本
- 自建运行要承担算力与维护开销
- 可能被用于伪造他人语音,滥用后果由使用者承担
Whisper Speech 是什么
Whisper Speech是一款完全开源的文本转语音模型,由Collabora和Lion在Juwels超级计算机上训练。它支持多种语言,提供Node.js、Python、Elixir、HTTP、Cog和Docker等多种调用形式,部署方式灵活,合成效率高。模型完全免费,开发者可自行修改和部署,用于构建各类语音应用。
你能用它做什么
- 将文本合成为多语言语音
- 集成到应用、脚本或服务中调用
- 自定义模型参数,做语音实验
- 通过Docker等方式灵活部署运行
适合谁使用
- 需要文本转语音能力的开发者
- 做语音合成实验的研究人员
- 想实践语音技术的开源爱好者
需要留意什么
Whisper Speech需要一定的技术基础,自建部署要承担算力和维护成本,开箱即用的体验有限。合成效果与输入文本和运行环境有关,关键场景需要实测调优。此外,语音合成技术可能被用于伪造他人声音,使用时务必遵守法律法规,滥用造成的一切后果由使用者承担。
常见问题
Whisper Speech收费吗?
不收费。Whisper Speech是完全开源的文本转语音模型,代码可自由获取、修改和部署使用。
支持哪些调用方式?
它支持Node.js、Python、Elixir、HTTP、Cog和Docker等多种形式输入,开发者可按项目需要灵活集成。
合成语音时要注意什么?
模型可能被用于伪造他人声音,使用时需遵守法律法规和伦理规范,用于欺骗、侵权等场景的后果由使用者承担。
为什么说它免费
官网写明的免费方式: 完全免费免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
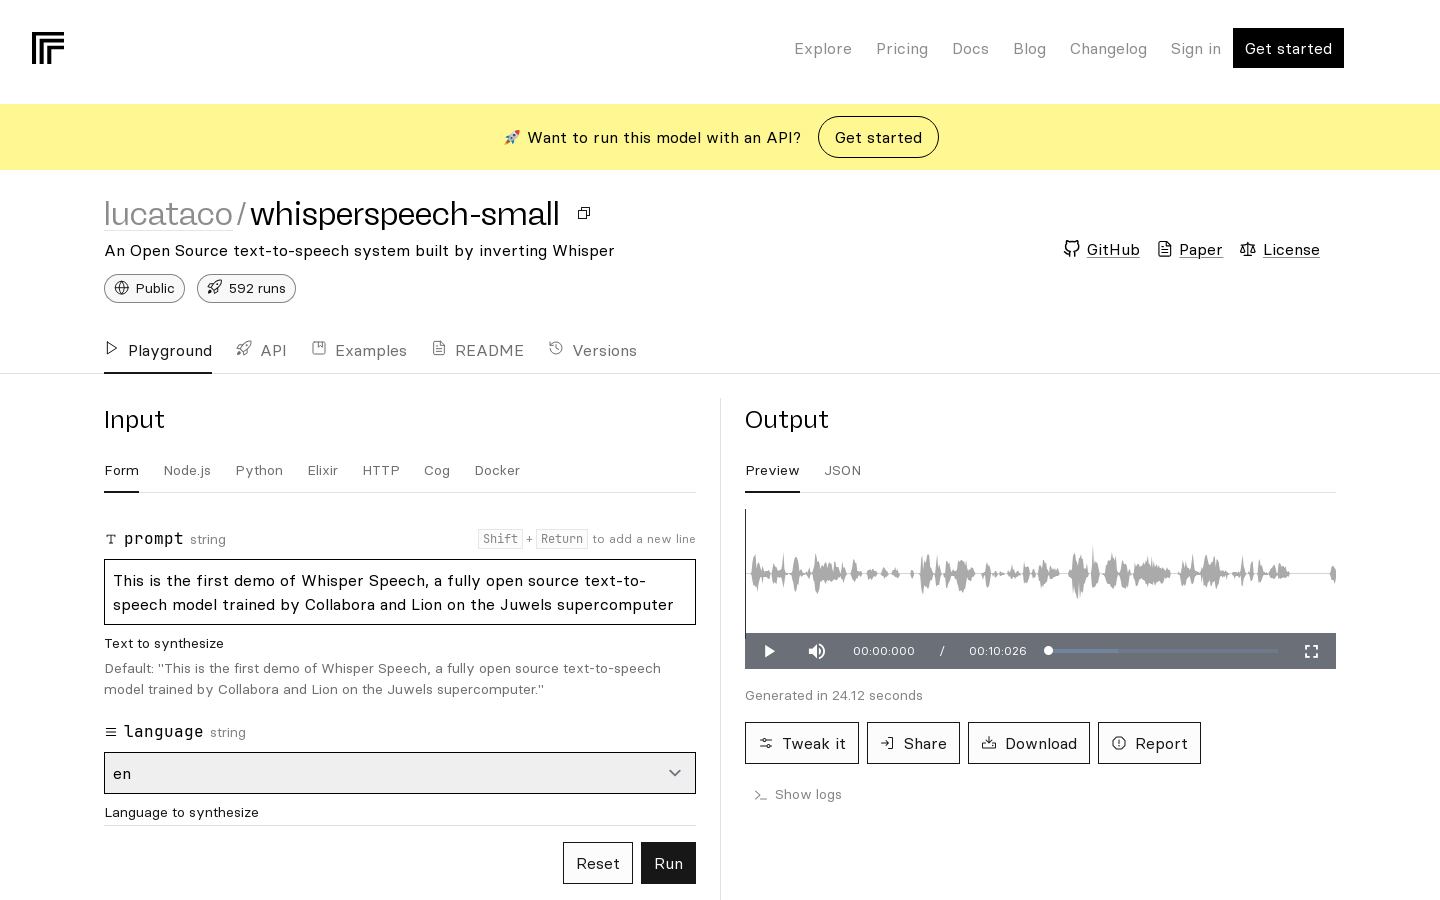
截图归档自收录页面,仅供预览参考。